Blog
Automatización documental: cómo implementarla con control
nbetters · · 14 min read
Qué es la automatización documental, cómo funciona con OCR e IA, cómo integrarla con CRM y ERP y qué gobierno exige para que los datos extraídos sean fiables.
La automatización documental consiste en usar software e inteligencia artificial para recibir, clasificar, leer y encaminar la información de facturas, formularios, correos, contratos y PDF sin que nadie la teclee de nuevo. Para una empresa mediana, el valor no está en el OCR en sí, sino en que los datos extraídos lleguen validados al CRM, al ERP o al flujo de aprobación correcto, con trazabilidad y con reglas claras para las excepciones. Esta guía explica cómo funciona el proceso, qué documentos conviene automatizar primero, cómo conectarlo con sus sistemas y qué gobierno evita que la solución se deteriore.
Puntos clave
- La automatización documental moderna combina captura, clasificación, extracción con OCR y aprendizaje automático, validación y entrega a un sistema de destino; automatizar solo la lectura no elimina el trabajo manual.
- El procesamiento manual de un documento cuesta entre 6 y 8 dólares según Microsoft, y el automatizado cuesta considerablemente menos, de modo que el volumen y la repetición definen el caso de negocio.
- Un flujo fiable siempre prevé la revisión humana de excepciones: ningún motor de extracción es infalible con formatos irregulares o escaneos de baja calidad.
- La integración con Dynamics 365, Dataverse y Power Automate permite que el documento sea el inicio de un proceso y no un archivo más en una carpeta.
- Sin roles de seguridad, entornos separados y controles de calidad desde el diseño, la automatización acumula errores silenciosos y sobrepersonalización.
Tabla de contenidos
- Qué es la automatización documental y qué resuelve
- Cómo funciona el procesamiento automatizado de documentos
- Qué documentos y procesos conviene automatizar primero
- Cómo medir los beneficios de la automatización documental
- Integrar la automatización documental con CRM y ERP
- Pasos para implementar la automatización sin perder el control
- Gobierno, seguridad y calidad de datos
- Nuestra perspectiva
- Cómo podemos ayudarle
- Preguntas frecuentes
- Fuentes
Qué es la automatización documental y qué resuelve
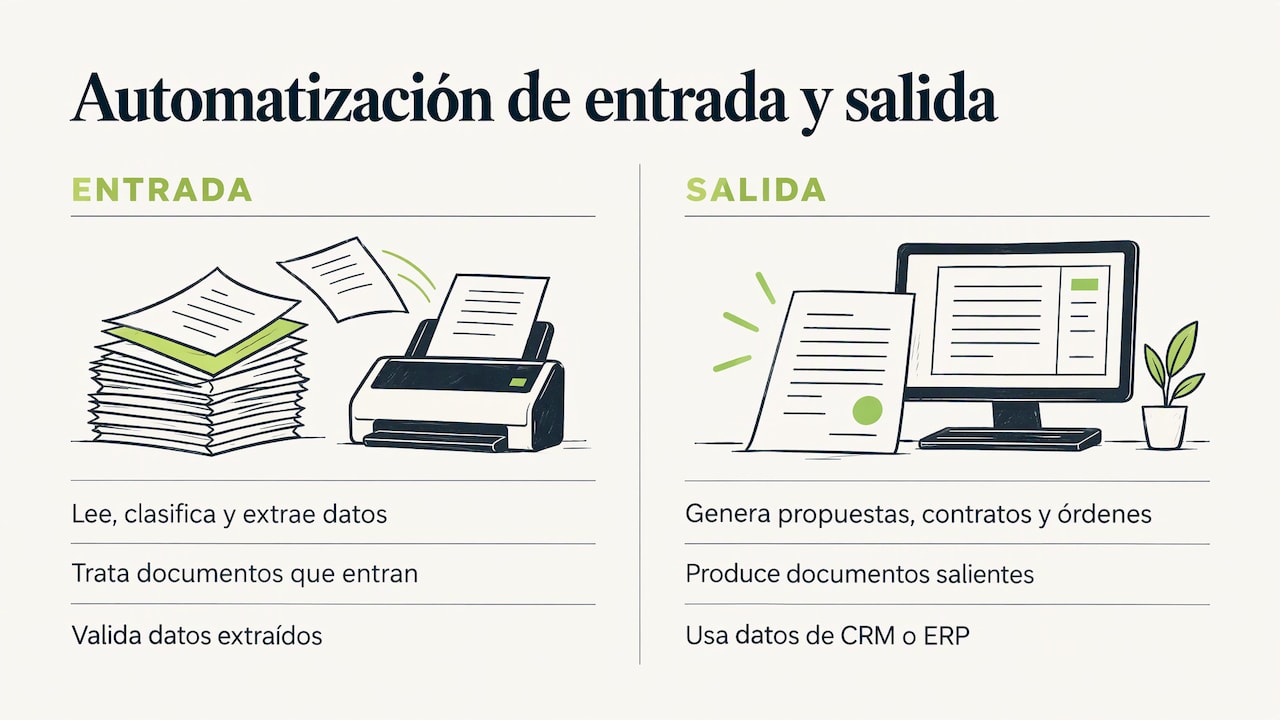
En los buscadores conviven dos expresiones, automatización documental y automatización de documentos, que designan dos prácticas cercanas pero distintas. La primera se refiere al tratamiento de los documentos que entran en la organización: leerlos, clasificarlos y extraer sus datos. La segunda suele aludir a la generación de documentos salientes, como propuestas, contratos u órdenes de compra, a partir de plantillas y datos del sistema. Una empresa madura necesita ambas, y la diferencia importa porque cada una exige decisiones de arquitectura distintas.
En su vertiente de entrada, el objetivo es sustituir tareas repetitivas, como la entrada de datos, la revisión documental y la clasificación de archivos, por flujos más rápidos, precisos y escalables. Esa liberación de tiempo tiene sentido operativo cuando el equipo dedica sus horas a excepciones, análisis y relación con el cliente. En la vertiente de salida, el objetivo es que el documento nazca con los datos correctos del CRM o del ERP, de modo que nadie copie cifras entre sistemas.
El término técnico que usan los fabricantes para la entrada es procesamiento inteligente de documentos, o IDP. IBM lo describe como el uso de automatización con IA y aprendizaje automático para clasificar documentos, extraer información y validar datos, tanto en formatos estructurados como semiestructurados y no estructurados, y aplicarla después a aplicaciones y flujos de trabajo empresariales.
Cómo funciona el procesamiento automatizado de documentos
Un flujo bien diseñado se entiende mejor como una cadena de fases, cada una con su propio punto de control. ServiceNow resume el proceso de IDP empresarial en cinco fases, que conviene tener presentes al diseñar cualquier solución.
Las cinco fases del flujo
- Recopilación. Los documentos llegan por correo, portal, carpeta compartida, escáner o aplicación y se centralizan en un punto de entrada único.
- Procesamiento previo. Se recorta, se binariza, se endereza la imagen y se reduce el ruido para que la lectura posterior sea más fiable.
- Clasificación. El sistema identifica si se trata de una factura, un pedido, un contrato o una identificación, y decide la ruta que corresponde.
- Extracción. Se combinan OCR e ICR con aprendizaje automático para leer campos, tablas y marcas de verificación.
- Validación. Reglas de negocio y técnicas apoyadas en IA contrastan los datos, y puede intervenir una persona como autenticador final.
La calidad de la entrada condiciona todo lo demás. Según una guía publicada en octubre de 2026, los motores de OCR actuales alcanzan entre un 95 % y un 99 % de precisión con texto impreso limpio y entre un 85 % y un 95 % con manuscritos, según la calidad del original. La lectura práctica de esas cifras es sencilla: un documento nítido casi no exige supervisión, mientras que un manuscrito o un escaneo deficiente siempre necesita una ruta de revisión.
El papel de la validación humana
El propio IBM advierte de que la tecnología OCR puede cometer errores y de que los datos extraídos pueden requerir revisión manual. Cuando un formato no se puede procesar o se detectan errores, el documento se marca para revisión humana y se corrige mediante entrada manual. Diseñar esa bandeja de excepciones desde el primer día es lo que convierte un piloto vistoso en un proceso en producción: quién la atiende, en qué plazo, con qué permisos y cómo se registra la corrección para mejorar el modelo.
Qué documentos y procesos conviene automatizar primero
No todos los documentos aportan el mismo retorno. Los mejores candidatos reúnen tres rasgos: llegan en volumen, siguen un patrón reconocible y alimentan una decisión o un registro posterior. Las facturas de proveedores, los pedidos de compra, los formularios de alta de clientes, las pólizas, las reclamaciones, los partes de obra y los contratos son los casos más frecuentes.
En Estados Unidos, un análisis de mercado sobre automatización de procesos con IA generativa señala que la demanda se concentra en procesos con información no estructurada, rutas de decisión variables e intervención humana frecuente, lo que amplía la oportunidad en finanzas, servicio al cliente, operaciones de TI, recursos humanos, cadenas de suministro, cumplimiento y operaciones de ventas. Dicho de otro modo, el documento ya no es solo un problema de administración: es la puerta de entrada de procesos completos.
| Área | Documentos típicos | Destino habitual del dato |
|---|---|---|
| Finanzas | Facturas, recibos, extractos | ERP, cuentas por pagar |
| Ventas | Propuestas, pedidos, contratos | CRM, facturación |
| Servicio al cliente | Correos, formularios, reclamaciones | Gestión de casos |
| Recursos humanos | Identificaciones, contratos, formularios de alta | Sistema de personal |
| Operaciones y cadena de suministro | Albaranes, órdenes de compra, partes | ERP, inventario |
| Cumplimiento y legal | Pólizas, acuerdos, certificados | Repositorio con control de acceso |
Para priorizar, conviene medir tres variables antes de elegir el primer caso: el volumen mensual de documentos, el tiempo manual por documento y la tasa actual de errores o devoluciones. Con esos tres datos se estima el coste actual y se fija un indicador de partida para comparar después. Si el coste manual por documento se sitúa en el rango que cita Microsoft, de 6 a 8 dólares, un volumen elevado justifica con rapidez un proyecto acotado.
Cómo medir los beneficios de la automatización documental
Los beneficios se dividen en cuatro familias que deben medirse con indicadores concretos, siempre contra la situación de partida:
- Coste por documento procesado, que incluye horas de personal, correcciones y retrasos de pago.
- Tiempo de ciclo, desde que el documento llega hasta que el dato está disponible en el sistema de destino.
- Tasa de excepciones y de errores detectados tarde, que indica la calidad real de la extracción y de las reglas.
- Adopción, es decir, qué proporción de documentos entra por el canal automatizado y no por correos paralelos o carpetas locales.
El indicador de adopción suele ser el más descuidado y el que más pesa. Una automatización que la mitad del equipo esquiva por costumbre no reduce costes. Por eso nuestro enfoque trata la capacitación y el acompañamiento posterior a la implementación como parte del proyecto y no como un añadido.
Integrar la automatización documental con CRM y ERP
La extracción de datos solo genera valor cuando el resultado entra en el sistema que lo utiliza. En el ecosistema de Microsoft, AI Builder y Power Automate permiten construir un flujo de procesamiento de documentos de extremo a extremo sin código: se extrae el contenido, se configura un proceso para validar los datos y se exportan a un ERP o a cualquier otro sistema de almacenamiento. Entre sus capacidades figuran plantillas de IA prediseñadas para facturas, recibos y documentos de identidad, modelos personalizados para extraer campos, marcas de verificación y tablas, una estación de validación humana y gobernanza del modelo de IA para desplegarlo en distintos entornos.
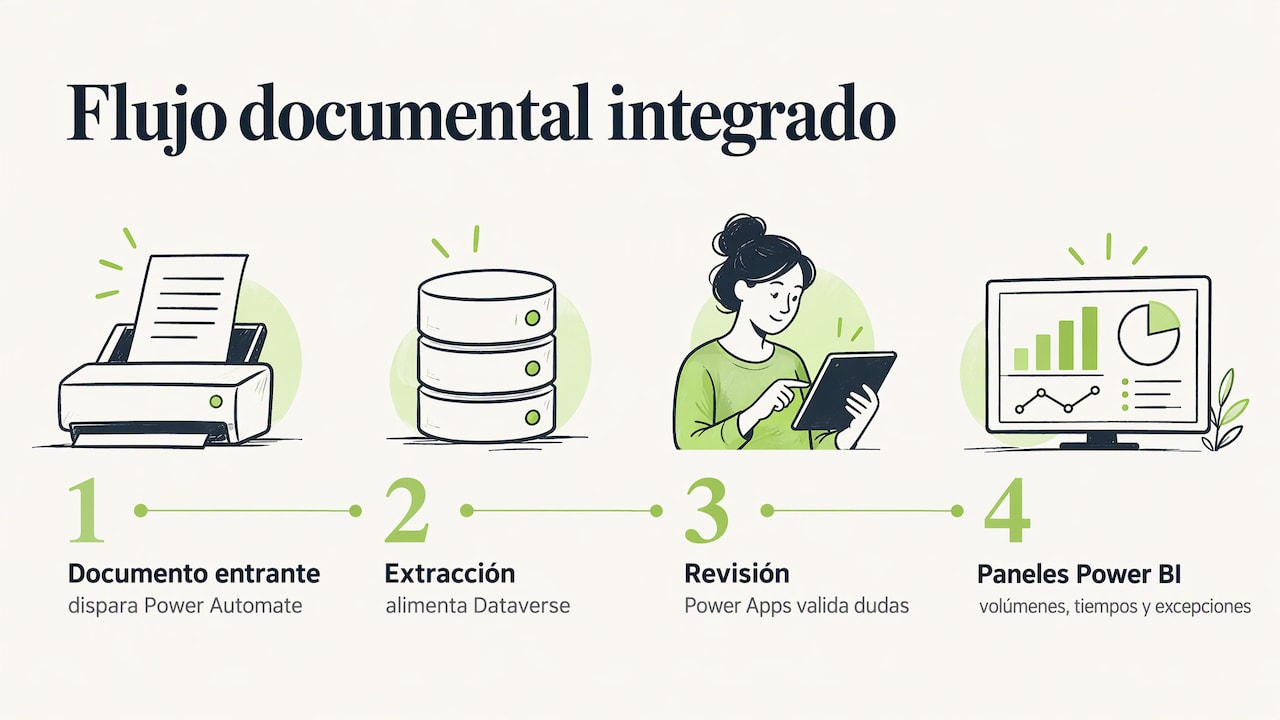
La arquitectura de referencia de Microsoft para AI Builder describe un escenario generalizable en el que intervienen Power Automate, Dataverse, Power Apps y Power BI: el documento entrante dispara el flujo, la extracción alimenta Dataverse, una aplicación permite revisar lo dudoso y los paneles de Power BI muestran volúmenes, tiempos y excepciones. Esa combinación es la que permite que el documento deje de ser un archivo y se convierta en un evento de negocio.
Dónde se rompen las integraciones
Los fallos más habituales no están en el OCR, sino en la unión con el ERP: códigos de proveedor duplicados, campos obligatorios que el documento no trae, tablas de precios desactualizadas o reglas de aprobación que viven en la cabeza de una persona. En manufactura, esas fricciones se concentran en la revisión de excepciones entre CRM y ERP, un tema que tratamos en nuestra guía sobre cómo automatizar la revisión de excepciones en la integración CRM-ERP. Para firmas de servicios profesionales, donde el documento se convierte en estimación, proyecto y factura, la guía de implementación de automatización para servicios profesionales muestra cómo encadenar esas etapas.
Pasos para implementar la automatización sin perder el control
Una implementación ordenada evita el error más caro, que es automatizar un proceso que nadie ha descrito. La secuencia que recomendamos es esta:
- Mapear el proceso real, no el que figura en el manual. Se documenta quién recibe el documento, qué decide y qué ocurre cuando falta un dato.
- Elegir un caso acotado, con volumen suficiente y un destino claro, por ejemplo facturas de un grupo de proveedores o formularios de alta de un tipo de cliente.
- Definir el modelo de datos de destino antes de extraer nada: campos, tipos, obligatoriedad y relaciones. Un buen modelado en Dataverse evita retrabajo posterior.
- Diseñar las reglas de validación y la ruta de excepciones, con responsables, plazos y registro de cada corrección.
- Construir y probar con documentos reales, incluidos los malos: escaneos torcidos, formatos nuevos y manuscritos.
- Medir, ajustar y ampliar. Se compara con el indicador de partida y solo entonces se incorpora el siguiente tipo de documento.
Cuando el flujo requiere conectar sistemas heterogéneos, la herramienta se elige por el caso y no por moda: Power Automate cuando el proceso vive en el ecosistema de Microsoft, y otras plataformas de orquestación o automatización robótica cuando hay aplicaciones antiguas sin interfaz de integración. Quien esté valorando alternativas puede consultar nuestra comparativa de Microsoft Power Platform frente a otras opciones.
Gobierno, seguridad y calidad de datos
Una automatización documental maneja información sensible por naturaleza: datos bancarios, identificaciones, condiciones comerciales y datos de empleados. El gobierno debe diseñarse con el flujo y no después. Tres controles sostienen la integridad de lo que se extrae.
Acceso por roles. En Dataverse, los roles de seguridad controlan el acceso a los datos, incluidos los roles basados en jerarquía, de modo que cada persona vea solo los registros que su función exige. La bandeja de excepciones, que a menudo muestra documentos completos, merece una definición de permisos propia.
Políticas de plataforma y trazabilidad. Microsoft agrupa en un único documento las consideraciones de seguridad y gobernanza de Power Platform, entre ellas el registro de actividad, que se integra con el Centro de Seguridad y Cumplimiento de Office. Ese registro permite reconstruir quién cambió qué y cuándo, algo indispensable en sectores regulados como seguros, legal o construcción.
Clasificación de la información. Las etiquetas de confidencialidad de Microsoft Purview permiten marcar los documentos según su sensibilidad para que esa protección los acompañe. Aplicarlas a los documentos que entran y salen del flujo reduce el riesgo de exposición accidental.
A estos controles técnicos se suman dos de calidad. El primero es un muestreo periódico: una persona verifica un porcentaje de documentos aceptados automáticamente, para detectar degradaciones que las reglas no ven. El segundo es la gestión de cambios: cada nuevo campo, plantilla o regla pasa por un entorno de pruebas antes de producción. Así se evita el deterioro gradual y la sobrepersonalización que convierten un sistema ordenado en una acumulación de parches. Si desea profundizar en el diseño de estas políticas, tenemos una guía sobre cómo elegir el gobierno de Power Platform.
Nuestra perspectiva
Después de acompañar proyectos de Dynamics 365 y Power Platform, vemos el mismo patrón: las empresas compran lectura de documentos y esperan que eso resuelva un proceso. No lo resuelve. La extracción es una pieza; lo que produce eficiencia es que el dato llegue al lugar correcto, con las reglas correctas y con alguien responsable de las excepciones.
Por eso partimos del proceso real del cliente y no de la configuración técnica. Primero mapeamos cómo circula el documento, después definimos el modelo de datos, la seguridad y la gobernanza, y solo entonces automatizamos. Ese orden protege la integridad de los datos desde el inicio y previene que el sistema se llene de personalizaciones que nadie recuerda por qué existen.
La adopción es la otra mitad del trabajo. Una automatización bien construida que el equipo no usa es un coste; por eso incluimos capacitación y soporte posterior, y diseñamos pantallas de revisión que hagan más fácil el camino correcto que el atajo. Para empresas medianas y en crecimiento, especialmente en sectores regulados, ese equilibrio entre automatización, control y uso real es lo que sostiene el resultado en el tiempo.
Derek
Cómo podemos ayudarle
En BetterS Agency implementamos Dynamics 365 y personalizamos Power Platform para que los documentos alimenten procesos y no carpetas. Trabajamos la automatización de procesos con Power Automate y otras herramientas, el desarrollo de integraciones con sistemas existentes, las soluciones de IA con Copilot Studio y OpenAI, los paneles de Power BI y la gobernanza de datos, además de la adopción y el soporte posterior.
Si quiere saber por dónde empezar, consulte nuestros servicios de automatización y Dynamics 365 o los paquetes de implementación, y cuéntenos qué documentos concentran hoy más trabajo manual en su operación.
Preguntas frecuentes
¿Cuál es la diferencia entre automatización documental y gestión documental?
La gestión documental almacena, organiza y controla el acceso y las versiones de los documentos. La automatización documental actúa sobre su contenido y su recorrido: lee los datos, los valida y dispara los pasos siguientes. En la práctica se complementan, porque un repositorio ordenado facilita que los flujos automáticos encuentren y clasifiquen la información correcta.
¿Qué tipos de documentos se pueden automatizar?
Se pueden automatizar documentos estructurados, como formularios, semiestructurados, como facturas y pedidos, y no estructurados, como correos o contratos. Los más rentables suelen ser los de mayor volumen y patrón repetido. Los manuscritos y los escaneos de baja calidad también se procesan, pero con una tasa de revisión humana mayor.
¿Es fiable el OCR para procesar documentos?
Con texto impreso limpio, los motores actuales logran precisiones altas, y con manuscritos la cifra es menor. Por eso un flujo profesional incluye reglas de validación y una ruta de revisión para lo dudoso. La fiabilidad del conjunto depende tanto del diseño de esas reglas como del motor de lectura.
¿Se puede conectar con Dynamics 365 o con un ERP?
Sí. Con AI Builder y Power Automate se puede extraer el contenido, validarlo y exportarlo a un ERP o a otro sistema de datos, y Dataverse puede actuar como capa intermedia para revisión y reporting. La clave está en definir antes el modelo de datos y las reglas de entrada, para que la integración no arrastre duplicados ni campos incompletos.
¿Cómo se protege la información sensible en el flujo?
Combinando roles de seguridad en Dataverse, registro de actividad y etiquetas de confidencialidad, además de entornos separados para pruebas y producción. La bandeja de excepciones requiere permisos específicos porque muestra documentos completos. Estas medidas se diseñan junto con el flujo y se revisan de forma periódica.
Fuentes
- Microsoft: ¿Qué es el procesamiento inteligente de documentos (IDP)?
- IBM: ¿Qué es el procesamiento de documentos?
- ServiceNow: ¿Qué es el procesamiento inteligente de documentos?
- Guía de automatización del procesamiento de documentos (octubre de 2026)
- Análisis del mercado estadounidense de automatización de procesos con GenAI
- Microsoft Adoption: Intelligent Document Processing
- Microsoft Learn: Mejorar el procesamiento de documentos con AI Builder
- Microsoft Learn: Roles de seguridad basados en jerarquía para Dataverse
- Microsoft Learn: Consideraciones de seguridad y gobernanza en Power Platform
- Microsoft Learn: Etiquetas de confidencialidad de Microsoft Purview